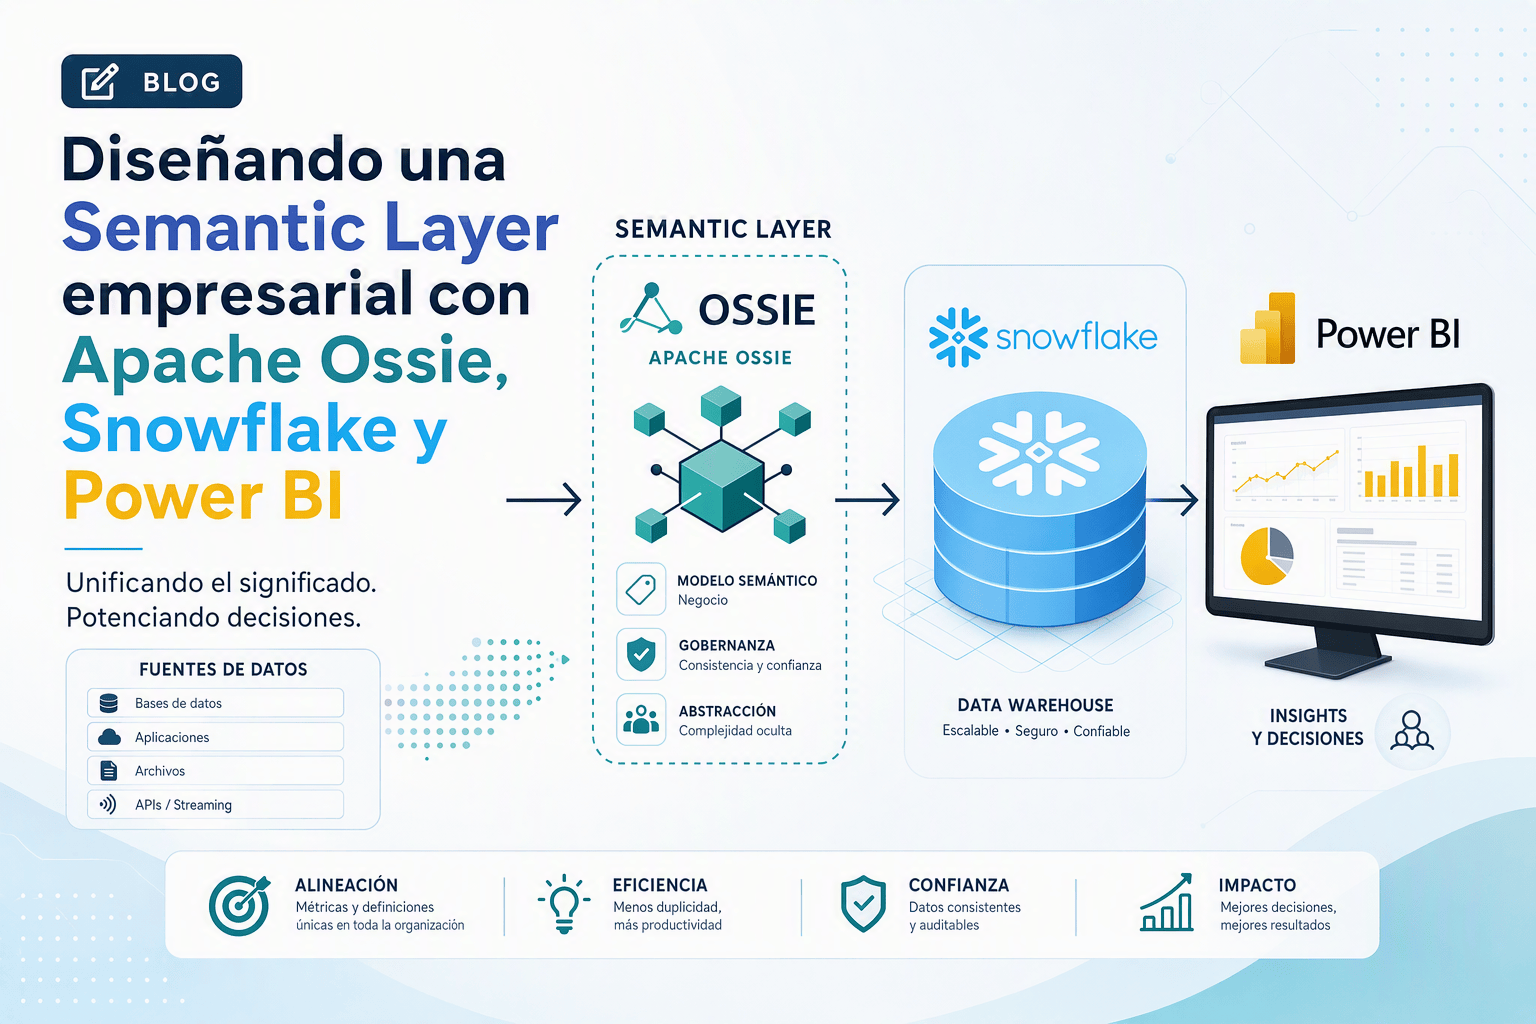
Durante años, las organizaciones han construido gran parte de su conocimiento de negocio directamente en herramientas de visualización como Power BI, Tableau o Looker. Métricas, dimensiones, relaciones, jerarquías y lógica de negocio han quedado encapsuladas dentro de modelos semánticos específicos de cada herramienta.
Sin embargo, la irrupción de la IA generativa, los agentes inteligentes y las arquitecturas analíticas abiertas está impulsando un nuevo paradigma: convertir la Semantic Layer en un activo corporativo independiente, reutilizable y gobernado desde la propia plataforma de datos.
En este artículo exploraremos qué es una Semantic Layer, cómo Apache Ossie está impulsando un estándar abierto para su definición, cómo Snowflake permite implementar Semantic Views basadas en YAML y cómo consumirlas desde Power BI mediante DirectQuery y autenticación mediante Key Pair.
¿Qué es una Semantic Layer?
Una Semantic Layer es una capa de abstracción que traduce la complejidad técnica de los datos a conceptos comprensibles para el negocio.
Su objetivo es responder a preguntas como:
- ¿Qué significa exactamente «Ingresos Netos»?
- ¿Cómo se calcula el EBITDA?
- ¿Qué diferencia existe entre un cliente activo y un cliente registrado?
- ¿Cuál es la relación entre pedidos, productos y clientes?
En lugar de exponer tablas y columnas técnicas, una Semantic Layer proporciona:
- Métricas empresariales.
- Dimensiones y atributos.
- Relaciones entre entidades.
- Jerarquías.
- Sinónimos y terminología corporativa.
- Reglas de negocio.
- Contexto para IA y agentes inteligentes.
Sin una capa semántica, cada equipo acaba implementando su propia definición de los indicadores, generando inconsistencias, pérdida de confianza y duplicidad de esfuerzos.
Como indica Snowflake, una Semantic Layer añade significado empresarial a los datos físicos y permite que herramientas analíticas, aplicaciones y agentes de IA trabajen utilizando conceptos de negocio en lugar de estructuras técnicas.
Del modelo semántico tradicional a la Semantic Layer empresarial
Históricamente, Power BI ha ofrecido uno de los mejores motores semánticos del mercado.
Su modelo tabular proporciona:
- Medidas DAX.
- Relaciones.
- Jerarquías.
- KPI.
- Roles de seguridad.
- Traducciones.
- Perspectivas.
Sin embargo, existe una limitación importante:
La semántica queda asociada al modelo concreto de Power BI.
Esto puede generar varios desafíos:
- Reimplementación de métricas en otras herramientas.
- Dificultad para reutilizar lógica entre plataformas.
- Dependencia tecnológica.
- Limitaciones para proporcionar contexto a agentes de IA externos.
Por esta razón muchas organizaciones están evolucionando hacia un modelo donde la definición semántica reside en la plataforma de datos y los consumidores (Power BI, agentes IA, aplicaciones o herramientas de autoservicio) simplemente la utilizan. Esta aproximación también aparece reflejada en iniciativas de Universal Semantic Layer impulsadas en torno a Snowflake y estándares abiertos.
¿Qué es Apache Ossie?
Apache Ossie (anteriormente Open Semantic Interchange u OSI) es un estándar abierto diseñado para intercambiar modelos semánticos entre distintas plataformas de datos, analítica e inteligencia artificial.
Open Semantic Interchange (OSI)
impulsado inicialmente por Snowflake junto con otros fabricantes del ecosistema de datos. Posteriormente fue aceptado en la Apache Software Foundation Incubator bajo el nombre:
Apache Ossie (Incubating)
Su objetivo es proporcionar un estándar común para definir:
- Métricas.
- Dimensiones.
- Relaciones.
- Entidades.
- Ontologías.
- Contexto empresarial.
utilizando un formato declarativo basado en YAML
La filosofía es sencilla:
Definir una vez el significado del negocio y reutilizarlo en cualquier plataforma.
Semantic Layer as Code
Uno de los conceptos más interesantes introducidos por Ossie es el enfoque:
Semantic Layer as Code
La semántica deja de estar encapsulada dentro de una herramienta gráfica y pasa a almacenarse como un artefacto versionable mediante Git.
Al utilizar YAML obtenemos:
- Versionado.
- Pull Requests.
- Integración CI/CD.
- Trazabilidad.
- Reutilización.
- Portabilidad entre plataformas.
Creando una Semantic View en Snowflake
Snowflake incorpora el concepto de Semantic Views, que permiten añadir significado de negocio directamente sobre los datos corporativos.
Actualmente Snowflake permite incluso crear Semantic Views directamente desde una definición Apache Ossie YAML mediante el procedimiento:
CALL SYSTEM$CREATE_SEMANTIC_VIEW_FROM_YAML( 'DEMO.USL',$$name: sales_analytics_sv_demo_yamldescription: Semantic view that defines a governed business layer for sales analytics. It models the sales transaction grain (facts) and the core business entities (customers, products, stores, discounts, and dates) with explicit relationships, business-friendly names, rich descriptions, and synonyms to improve discovery and natural-language querying with Cortex Analyst and BI tools.tables: - name: fact_sales description: Sales fact table at transaction (or line) grain. Each row represents a sale event, capturing quantities and monetary amounts (gross and discount) and linking to the main business dimensions (customer, product, store, discount, and date). This is the central table for revenue and volume metrics. base_table: database: DEMO schema: USL table: FACT_SALES facts: - name: sale_id expr: SALE_ID data_type: NUMBER description: Unique identifier of the sale transaction (business key at fact grain). synonyms: - sale id - sales id - transaction id - tx id - id venta - id transacción - identificador venta - name: quantity expr: QUANTITY data_type: NUMBER description: > Number of product units sold in the transaction. Used for volume, unit-based KPIs, and average calculation. synonyms: - quantity - units - unit count - items - items sold - cantidad - unidades - uds - unidades vendidas - volumen - name: gross_amount expr: GROSS_AMOUNT data_type: NUMBER description: > Gross sales amount before applying discounts. Represents the list or base monetary value of the transaction and is the primary input for gross re synonyms: - gross amount - gross sales - gross revenue (raw) - sales amount - sales value - revenue before discount - importe bruto - ventas brutas - valor bruto - facturación bruta - ingreso bruto - name: discount_amount expr: DISCOUNT_AMOUNT data_type: NUMBER description: > Discount value applied to the transaction. Used to compute net revenue and discount-related KPIs (e.g., discount rate, savings) synonyms: - discount amount - discount value - discount - markdown - promotion discount - rebate - importe descuento - descuento aplicado - valor descuento - rebaja - promoción time_dimensions: - name: order_date expr: ORDER_DATE data_type: DATE description: > Calendar date when the sale/order occurred (transaction date). Used for time-based grouping, trend analysis, and period-over-period comparisons synonyms: - order date - transaction date - sales date - purchase date - date of purchase - fecha pedido - fecha de compra - fecha venta - día de compra - día de venta - name: customers description: > Customer dimension containing the main customer attributes used for segmentation and geographic analysis. Each customer is uniquely identified by CUSTOMER_ID. base_table: database: DEMO schema: USL table: DIM_CUSTOMER primary_key: columns: - CUSTOMER_ID dimensions: - name: country expr: COUNTRY data_type: VARCHAR description: > Customer country (billing or residence depending on source system). Used for geo analysis and market breakdown. synonyms: - country - nation - market country - customer country - país - nación - país cliente - mercado - ubicación país - name: segment expr: SEGMENT data_type: VARCHAR description: > Business segmentation label for the customer (e.g., B2C/B2B, premium, SMB, enterprise). Used to compare performance across customer groups. synonyms: - segment - customer segment - market segment - customer group - customer tier - segmento - segmento cliente - grupo cliente - tipología cliente - tipo de cliente - name: customer_name expr: CUSTOMER_NAME data_type: VARCHAR description: > Human-readable customer name used for reporting and top-N analyses. synonyms: - customer - customer name - client - client name - account - account name - cliente - nombre cliente - cuenta - nombre de cuenta - name: products description: > Product dimension containing product classification attributes such as category and brand. Each product is uniquely identified by PRODUCT_ID. base_table: database: DEMO schema: USL table: DIM_PRODUCT primary_key: columns: - PRODUCT_ID dimensions: - name: category expr: CATEGORY data_type: VARCHAR description: > Product category used for assortment analysis and category performance reporting. synonyms: - category - product category - product family - categoría - categoría producto - familia producto - línea producto - tipo producto - name: brand expr: BRAND data_type: VARCHAR description: > Product brand used for brand-share and brand performance reporting synonyms: - brand - product brand - manufacturer - marca - marca producto - fabricante - proveedor marca - name: discounts description: > Discounts dimension describing discount or promotion codes that can be applied to sales. base_table: database: DEMO schema: USL table: DIM_DISCOUNTS primary_key: columns: - DISCOUNT_CODE dimensions: - name: discount_code expr: DISCOUNT_CODE data_type: VARCHAR unique: true description: > Unique discount/promotion identifier applied to a sale transaction. Useful to analyze promotion effectiveness and discount utilization. synonyms: - discount code - promo code - promotion code - coupon code - offer code - código descuento - código promo - cupón - código cupón - código oferta - name: stores description: Store dimension base_table: database: DEMO schema: USL table: DIM_STORE primary_key: columns: - STORE_ID dimensions: - name: store_name expr: STORE_NAME data_type: VARCHAR description: > Store display name (branch, site, or channel label). synonyms: - store - store name - branch - branch name - location name - tienda - nombre tienda - sucursal - punto de venta - establecimiento - name: store_type expr: STORE_TYPE data_type: VARCHAR description: > Store type or channel classification (e.g., retail, online, outlet, franchise). Used for channel mix and store-type performance comparisons. synonyms: - store type - channel - sales channel - store channel - format - tipo tienda - canal - canal de venta - formato - tipo de canal - name: dates description: > Date dimension providing calendar attributes to support time-based rollups and consistent period definitions. base_table: database: DEMO schema: USL table: DIM_DATE primary_key: columns: - DATE_ID dimensions: - name: quarter expr: QUARTER data_type: VARCHAR description: > Calendar quarter label used for quarterly aggregation (e.g., Q1, Q2, Q3, Q4). synonyms: - quarter - fiscal quarter - calendar quarter - trimestre - trimestre fiscal - trimestre calendario - Q1 - Q2 - Q3 - Q4relationships: - name: sales_to_customers left_table: fact_sales right_table: customers relationship_columns: - left_column: CUSTOMER_ID right_column: CUSTOMER_ID - name: sales_to_products left_table: fact_sales right_table: products relationship_columns: - left_column: PRODUCT_ID right_column: PRODUCT_ID - name: sales_to_discounts left_table: fact_sales right_table: discounts relationship_columns: - left_column: DISCOUNT_CODE right_column: DISCOUNT_CODE - name: sales_to_dates left_table: fact_sales right_table: dates relationship_columns: - left_column: ORDER_DATE right_column: DATE_ID - name: sales_to_stores left_table: fact_sales right_table: stores relationship_columns: - left_column: STORE_ID right_column: STORE_IDmetrics: - name: gross_revenue expr: SUM(fact_sales.gross_amount) description: > Total gross revenue: sum of gross sales amounts before discounts. Use this metric to evaluate topline sales performance regardless of promotions. synonyms: - gross revenue - gross sales - total gross sales - total sales (gross) - revenue before discounts - ventas brutas - facturación bruta - ingresos brutos - total ventas brutas - total bruto - name: net_revenue expr: SUM(fact_sales.gross_amount - fact_sales.discount_amount) description: > Net revenue: sum of gross amount minus discount amount. Represents realized revenue after discounts are applied; suitable for profitability and promotion-aware performance reporting. synonyms: - net revenue - net sales - total net sales - revenue after discount - realized revenue - ventas netas - facturación neta - ingresos netos - total ventas netas - neto - name: total_quantity expr: SUM(fact_sales.quantity) description: > Total quantity sold: sum of units sold across transactions. Useful for volume, demand, and mix analysis independent of price. synonyms: - total quantity - total units - units sold - items sold - sales volume - cantidad total - unidades totales - unidades vendidas - volumen vendido - total unidades - name: average_order_value expr: AVG(fact_sales.gross_amount - fact_sales.discount_amount) description: > Average order value (AOV): average net amount per transaction (gross minus discount). Used to measure basket size and commercial effectiveness; can be analyzed by customer, product, store, and time. synonyms: - average order value - AOV - avg order value - average basket value - average ticket - ticket size - valor medio pedido - valor medio de compra - ticket medio - cesta media$$);
El flujo típico sería:
Paso 1. Crear el YAML Ossie
Paso 2. Almacenarlo en Git
Paso 3. Publicar la Semantic View
Consumir Snowflake desde Power BI
Una vez expuesta la semántica en Snowflake, Power BI puede conectarse usando el conector nativo de Snowflake.
La arquitectura recomendada es:
Power BI Desktop | DirectQuery |Snowflake Semantic View | Snowflake Data Platform
De esta forma:
- Los datos permanecen en Snowflake.
- La seguridad sigue gobernada por Snowflake.
- No existe duplicación de datos.
- Las consultas se ejecutan en origen.
Este patrón resulta especialmente interesante cuando se utilizan políticas de seguridad, masking, gobierno de datos y Horizon Catalog directamente desde Snowflake.
Autenticación mediante Key Pair
Snowflake permite autenticación mediante:
- Usuario y contraseña.
- OAuth.
- SSO.
- Key Pair Authentication.
La autenticación por Key Pair utiliza criptografía asimétrica y el proceso completo de cara a conectar ambos mundos es el siguiente:
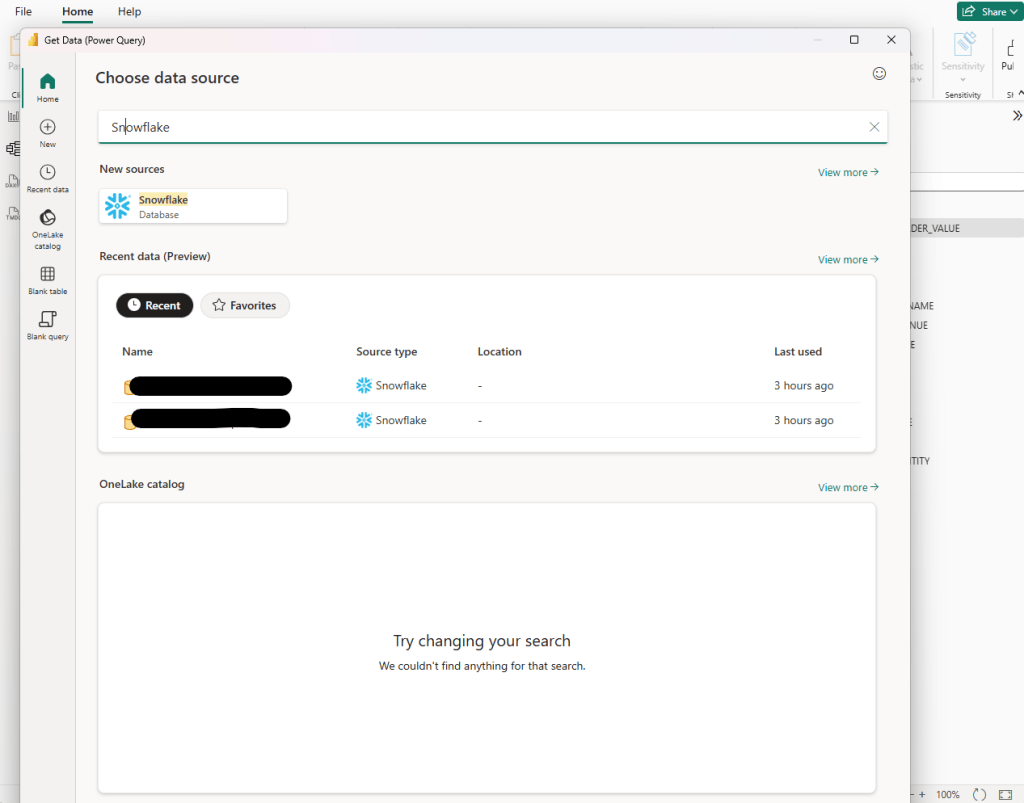
Seleccionamos más fuentes y filtramos por Snowflake
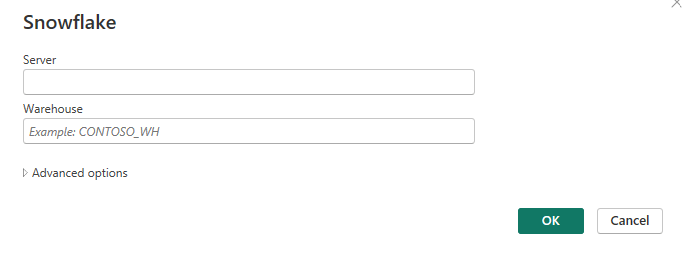
Al pulsar sobre Snowflake, debemos introducir el servidor y el warehouse que actúa como recurso de computación.
Al pulsar sobre Advanced Options es donde configuraremos realmente la conexión a la capa semántica creada en Snowflake.
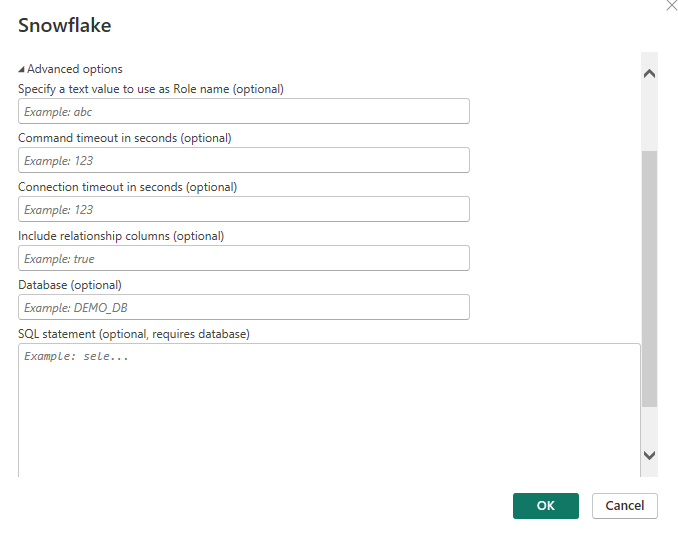
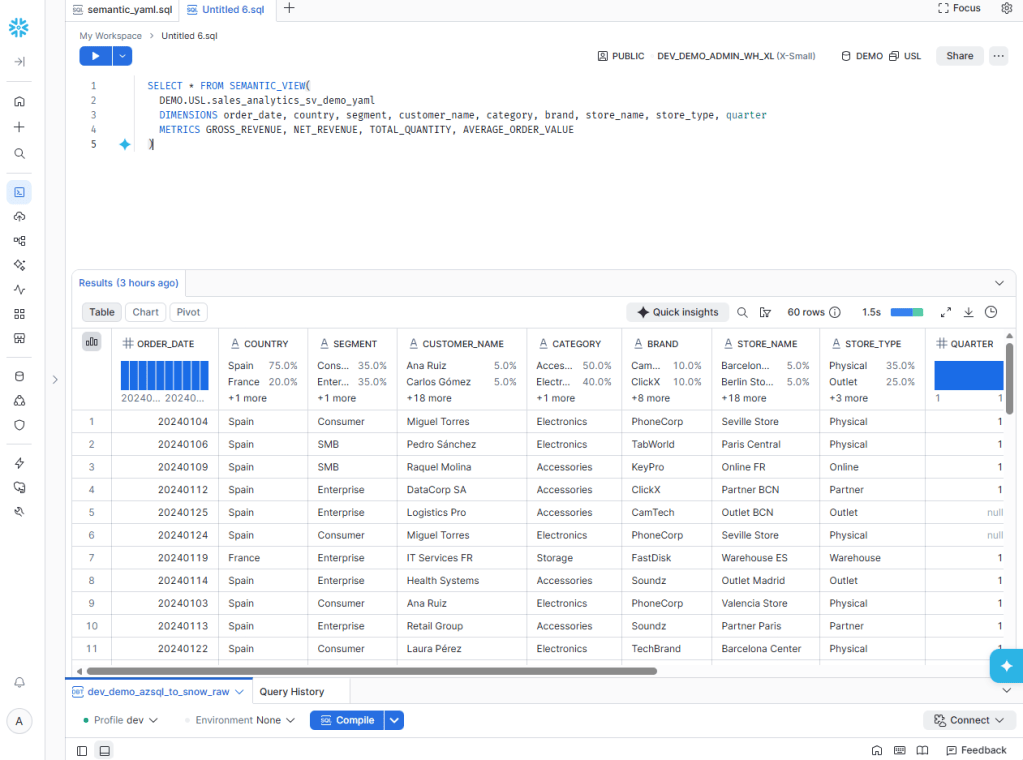
Además de indicar la Database a emplear, se debe incluir el SQL Statement que aparece debajo ya que a día de hoy, Power BI no soporta la conexión directa a una Semantic View de Snowflake.
SELECT * FROM SEMANTIC_VIEW( DEMO.USL.sales_analytics_sv_demo_yaml DIMENSIONS order_date, country, segment, customer_name, category, brand, store_name, store_type, quarter METRICS GROSS_REVENUE, NET_REVENUE, TOTAL_QUANTITY, AVERAGE_ORDER_VALUE)
El resultado de esa consulta es lo que puedes ver debajo al hacerlo en Snowflake.
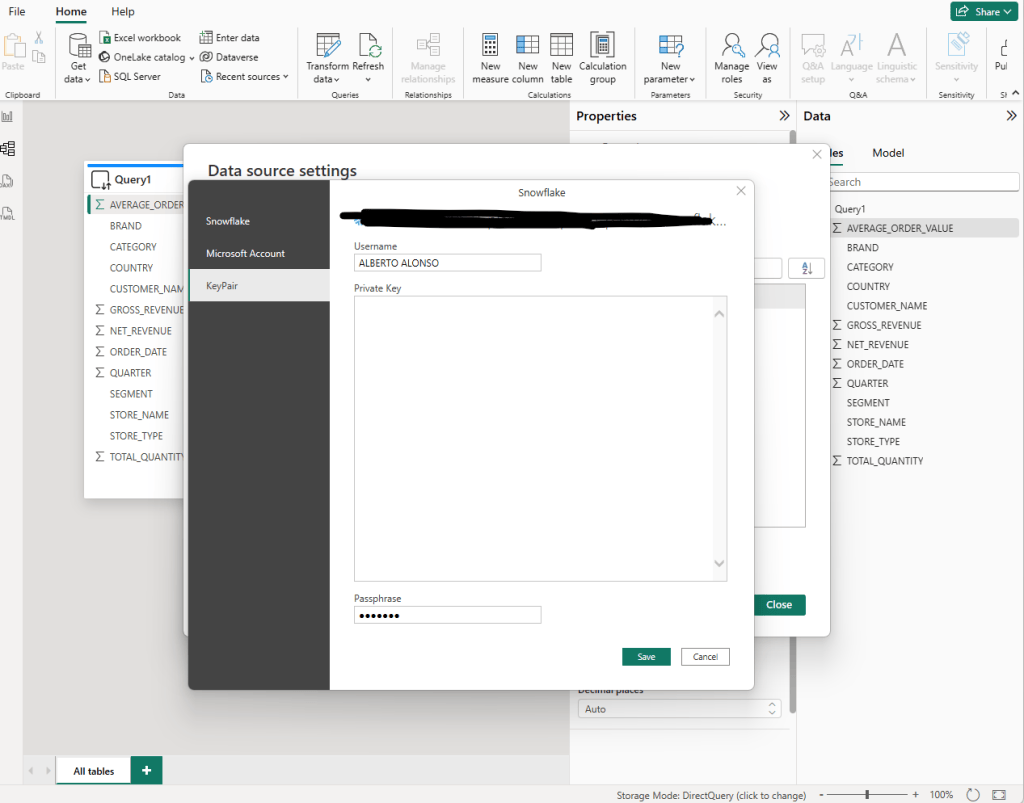
Ahora ya solo falta incluir la Private Key creada en Snowflake junto con la Passphrase que también devuelve el proceso previo.
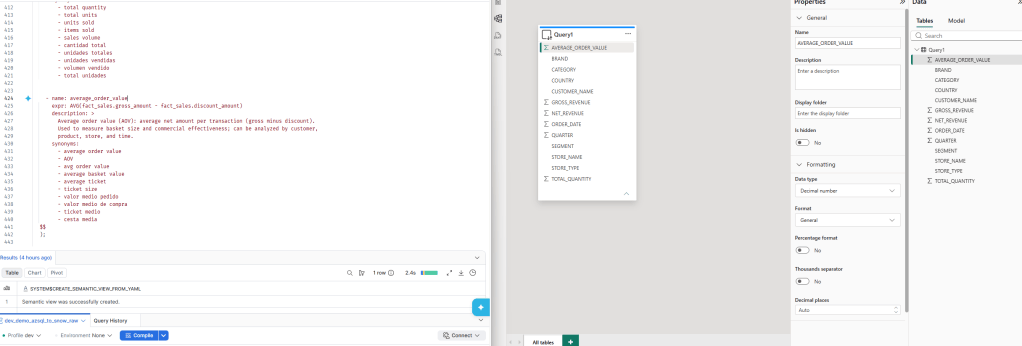
Una vez realiada y validada la conexión, ya puedo ver que en Power Bi aparecen todos los campos de la Semantic View de Snowflake. Si bien, no hay forma actualmente de consumir el detalle de dicha semántica, lo que obliga a trabajar dos veces.
Beneficios de esta arquitectura
1. Definición única del negocio
Una única definición para métricas y KPIs.
2. Reutilización
La misma semántica puede ser utilizada por:
- Power BI.
- Agentes IA.
- Aplicaciones.
- Herramientas de Data Science.
- Motores SQL.
3. Menor dependencia tecnológica
La semántica deja de estar ligada a una herramienta concreta.
4. Mayor gobernanza
La lógica empresarial pasa a formar parte de la plataforma corporativa.
5. Mejor preparación para IA
Los agentes disponen de:
- Métricas.
- Sinónimos.
- Relaciones.
- Ontologías.
- Reglas de negocio.
Todo ello accesible mediante una representación estándar.
Inconvenientes y retos
Aunque el enfoque es muy prometedor, también presenta desafíos.
Pérdida de funcionalidades específicas de Power BI
El modelo tabular de Power BI sigue ofreciendo capacidades muy maduras:
- DAX avanzado.
- Calculation Groups.
- Perspectivas.
- Optimización Vertipaq.
- Composite Models.
No toda esta riqueza semántica existe todavía en estándares abiertos.
Contexto funcional disperso
En muchos proyectos:
- Definiciones de negocio.
- Descripciones.
- KPI.
- Documentación funcional.
siguen viviendo dentro de Power BI.
Al externalizar la semántica existe el riesgo de perder parte de ese conocimiento si no se acompaña de un gobierno adecuado.
Mayor complejidad operativa
Ahora debemos gobernar:
- YAML.
- Git.
- CI/CD.
- Catálogo.
- Semantic Views.
Lo que introduce un nuevo proceso de desarrollo.
Rendimiento
DirectQuery aporta gobierno y tiempo real, pero en algunos escenarios puede ofrecer menor rendimiento que modelos Import optimizados mediante VertiPaq.
Conclusión
Power BI sigue siendo una de las mejores plataformas analíticas del mercado y continuará desempeñando un papel fundamental en la experiencia de consumo, visualización y exploración de datos.
Sin embargo, la aparición de estándares abiertos como Apache Ossie y capacidades como las Snowflake Semantic Views está impulsando una evolución natural: convertir la semantic layer en un activo corporativo compartido, independiente de cualquier herramienta concreta.
La pregunta ya no es si Power BI debe tener modelo semántico o no.
La verdadera pregunta es:
¿Qué parte de la semántica pertenece a la herramienta analítica y qué parte debería convertirse en un activo empresarial reutilizable por humanos, aplicaciones y agentes de IA?
Y probablemente la respuesta esté en encontrar un equilibrio entre ambos mundos.
 Alb3rto Alonso
