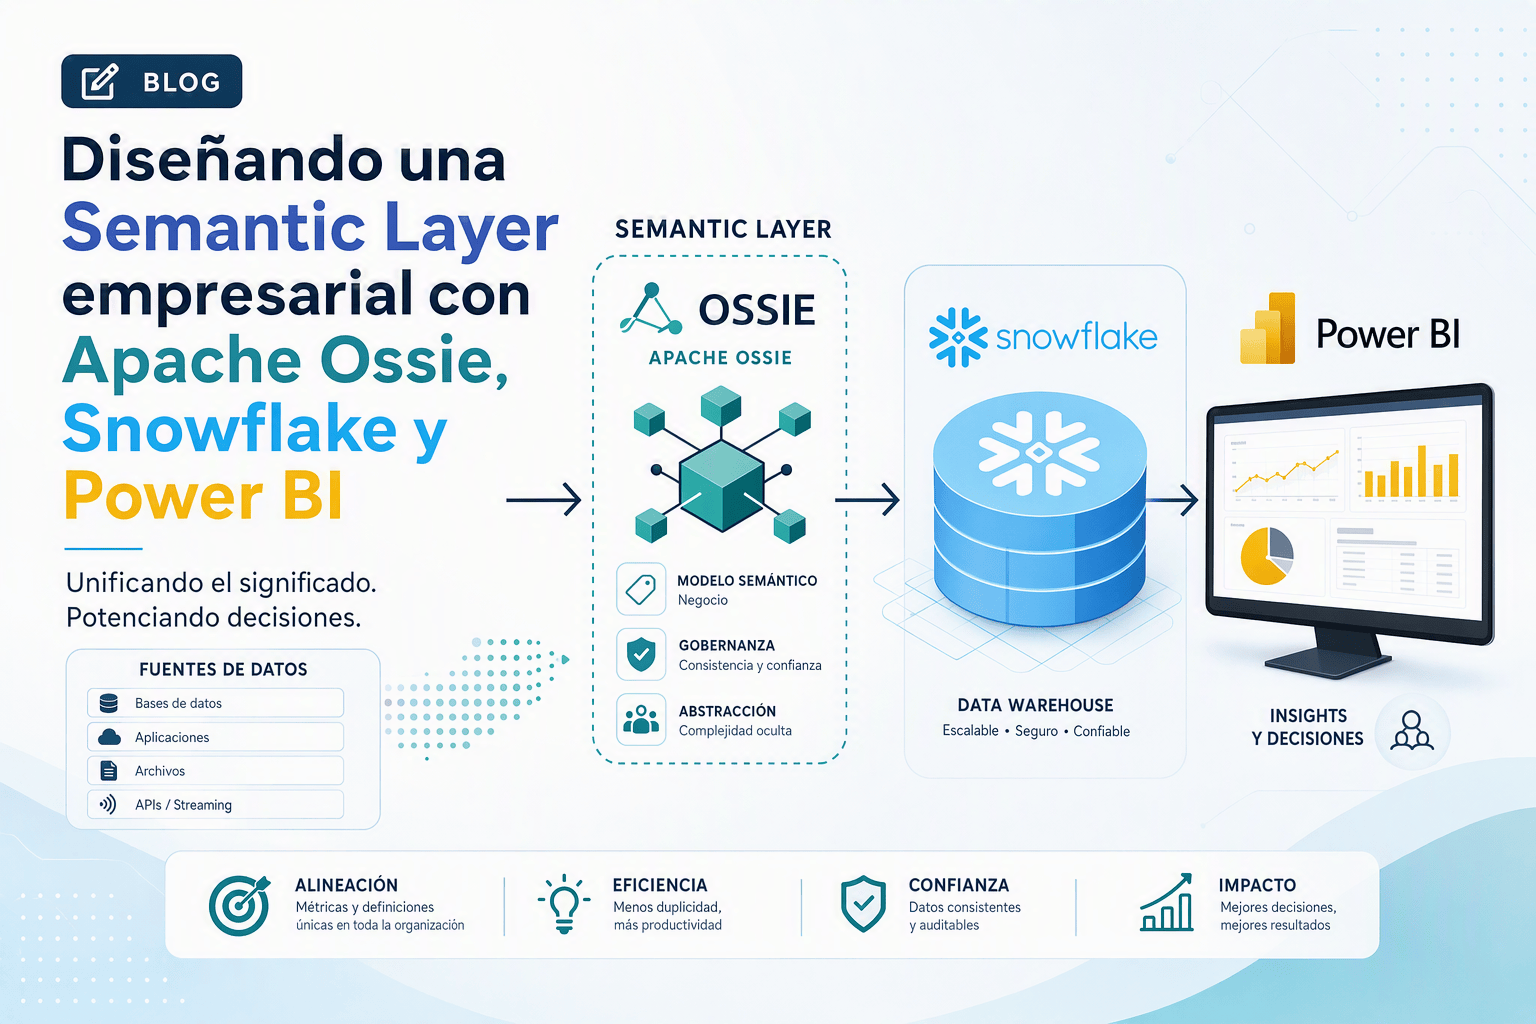
Durante años, las organizaciones han construido gran parte de su conocimiento de negocio directamente en herramientas de visualización como Power BI, Tableau o Looker. Métricas, dimensiones, relaciones, jerarquías y lógica de negocio han quedado encapsuladas dentro de modelos semánticos específicos de cada herramienta. Sin embargo, la irrupción de la IA generativa, los agentes inteligentes ySigue leyendo «Diseñando una Semantic Layer empresarial con Apache Ossie, Snowflake y Power BI»
Archivo de etiqueta: #Microsoft
CTAS vs INSERT…. SELECT en Microsoft Fabric Data Warehouse:¿Cuál elegir para maximizar el rendimiento?
Una de las preguntas más habituales cuando se diseñan procesos de carga en Microsoft Fabric Data Warehouse es si resulta más eficiente utilizar un CREATE TABLE AS SELECT (CTAS) o un INSERT INTO…SELECT para copiar datos entre tablas. La respuesta corta es: depende de si la tabla destino ya existe y del objetivo de laSigue leyendo «CTAS vs INSERT…. SELECT en Microsoft Fabric Data Warehouse:¿Cuál elegir para maximizar el rendimiento?»
Caso práctico: ampliar una columna en Fabric Data Warehouse sin reconstruir la tabla

Uno de los cambios más frecuentes en cualquier solución analítica es la propia evolución del modelo de datos. Suele suceder que, lo que inicialmente parecía suficiente temrina quedándose corto en cuanto que el negocio crece, aparecen nuevas fuentes de datos o se modifican los requisitos funcionales. Hasta ahora, en Microsoft Fabric Data Warehouse, una modificaciónSigue leyendo «Caso práctico: ampliar una columna en Fabric Data Warehouse sin reconstruir la tabla»
Cuando el Time Travel deja de ser una función técnica y se convierte en gobierno del dato

Durante años, la retención de datos históricos ha sido tratada como una decisión puramente técnica: más días significan más capacidad de recuperación, menos días implican menos coste. Sin embargo, la nueva capacidad de configuración del período de retención en Microsoft Fabric Data Warehouse permite abordar esta decisión desde una perspectiva mucho más interesante: alinear laSigue leyendo «Cuando el Time Travel deja de ser una función técnica y se convierte en gobierno del dato»
OneLake Lifecycle Management en Microsoft Fabric: menos costes, más eficiencia y una estrategia sostenible para el dato

Uno de los retos más habituales que encuentro en proyectos de datos corporativos no es cómo almacenar información, sino cómo hacerlo de forma eficiente cuando los volúmenes crecen año tras año. En muchas organizaciones, la mayor parte de los datos almacenados son históricos, se consultan de forma muy ocasional, pero siguen siendo necesarios por motivosSigue leyendo «OneLake Lifecycle Management en Microsoft Fabric: menos costes, más eficiencia y una estrategia sostenible para el dato»
GPU Accelerate Fabric Data Warehouse: ¿por qué Microsoft está reinventando el Data Warehouse?

Esta entrada continua profundizando en los anuncios del pasado Microsoft Build 2026 y entrando en detalle sobre lo que representan como estrategia a futuro. Hoy el foco lo pongo en por qué Microsoft está «vitaminando» su Data Warehouse en Fabric. Durante años, la evolución de los Data Warehouse ha estado marcada por mejoras incrementales: másSigue leyendo «GPU Accelerate Fabric Data Warehouse: ¿por qué Microsoft está reinventando el Data Warehouse?»
De Data Platform a Agent Platform: cómo Rayfin redefine el papel de Microsoft Fabric

Durante los últimos años hemos visto cómo las plataformas de datos evolucionaban desde simples repositorios analíticos hacia ecosistemas completos capaces de soportar inteligencia artificial, gobierno del dato y analítica avanzada. Sin embargo, Microsoft Build 2026 dejó entrever un nuevo cambio de paradigma: el objetivo ya no es únicamente almacenar, transformar y analizar información, sino proporcionarSigue leyendo «De Data Platform a Agent Platform: cómo Rayfin redefine el papel de Microsoft Fabric»
FinOps en Microsoft Fabric: cómo controlar el coste de almacenamiento en OneLake
Cuando hablamos de optimización en Microsoft Fabric, la mayoría de conversaciones se centran en: Sin embargo, hay un componente que suele quedar fuera del foco… hasta que es demasiado tarde: «el crecimiento descontrolado del almacenamiento en OneLake« En entornos productivos, este es uno de los principales drivers de coste oculto. El problema real: el almacenamientoSigue leyendo «FinOps en Microsoft Fabric: cómo controlar el coste de almacenamiento en OneLake»
Snowflake + Power BI: cómo gestionar datos sensibles
Trabajar con información sensible —salarios, datos personales, contratos, etc.— implica algo más allá de modelar datos y construir dashboards. Implica diseñar arquitecturas de seguridad coherentes entre plataforma y herramienta de visualización. En este artículo voy a explicar un punto clave que suele generar confusión en muchos proyectos: Cómo combinar Snowflake y Power BI para gestionarSigue leyendo «Snowflake + Power BI: cómo gestionar datos sensibles»
dbt en Microsoft Fabric: del SQL al analytics gobernado

Durante años, dbt (data build tool) se ha consolidado como el estándar de facto para el analytics engineering: transformar datos con SQL, versionarlos como código, testearlos y documentarlos de forma reproducible.Hasta hace poco, su uso en Microsoft requería combinar herramientas externas, CLI, runners propios o plataformas de terceros. Con la llegada de dbt Jobs nativosSigue leyendo «dbt en Microsoft Fabric: del SQL al analytics gobernado»
 Alb3rto Alonso
